一、平台侧的三个数量级挑战
前面讲过 Agent 的工程实现——那是一个"每台终端上跑一份"的问题。平台侧是另一个维度的问题,它要同时面对三个数量级:
- 终端数量:十万级到百万级Agent 需要保持连接、上报数据、接收指令。
- 数据量:单台终端每天产生数百MB 遥测(详细模式下甚至 GB 级),十万台终端就是每天数十 TB 的写入。
- 查询并发:SOC分析师随时发起跨全网的狩猎查询("过去 30 天所有终端上执行过某命令行的进程"),这类查询涉及数十亿条记录。
这三个数量级叠加,平台设计的核心矛盾就出现了:采集要全、存储要久、查询要快、成本要低,四者互相制约。本文拆解一个 EDR 云端管理平台的架构设计。
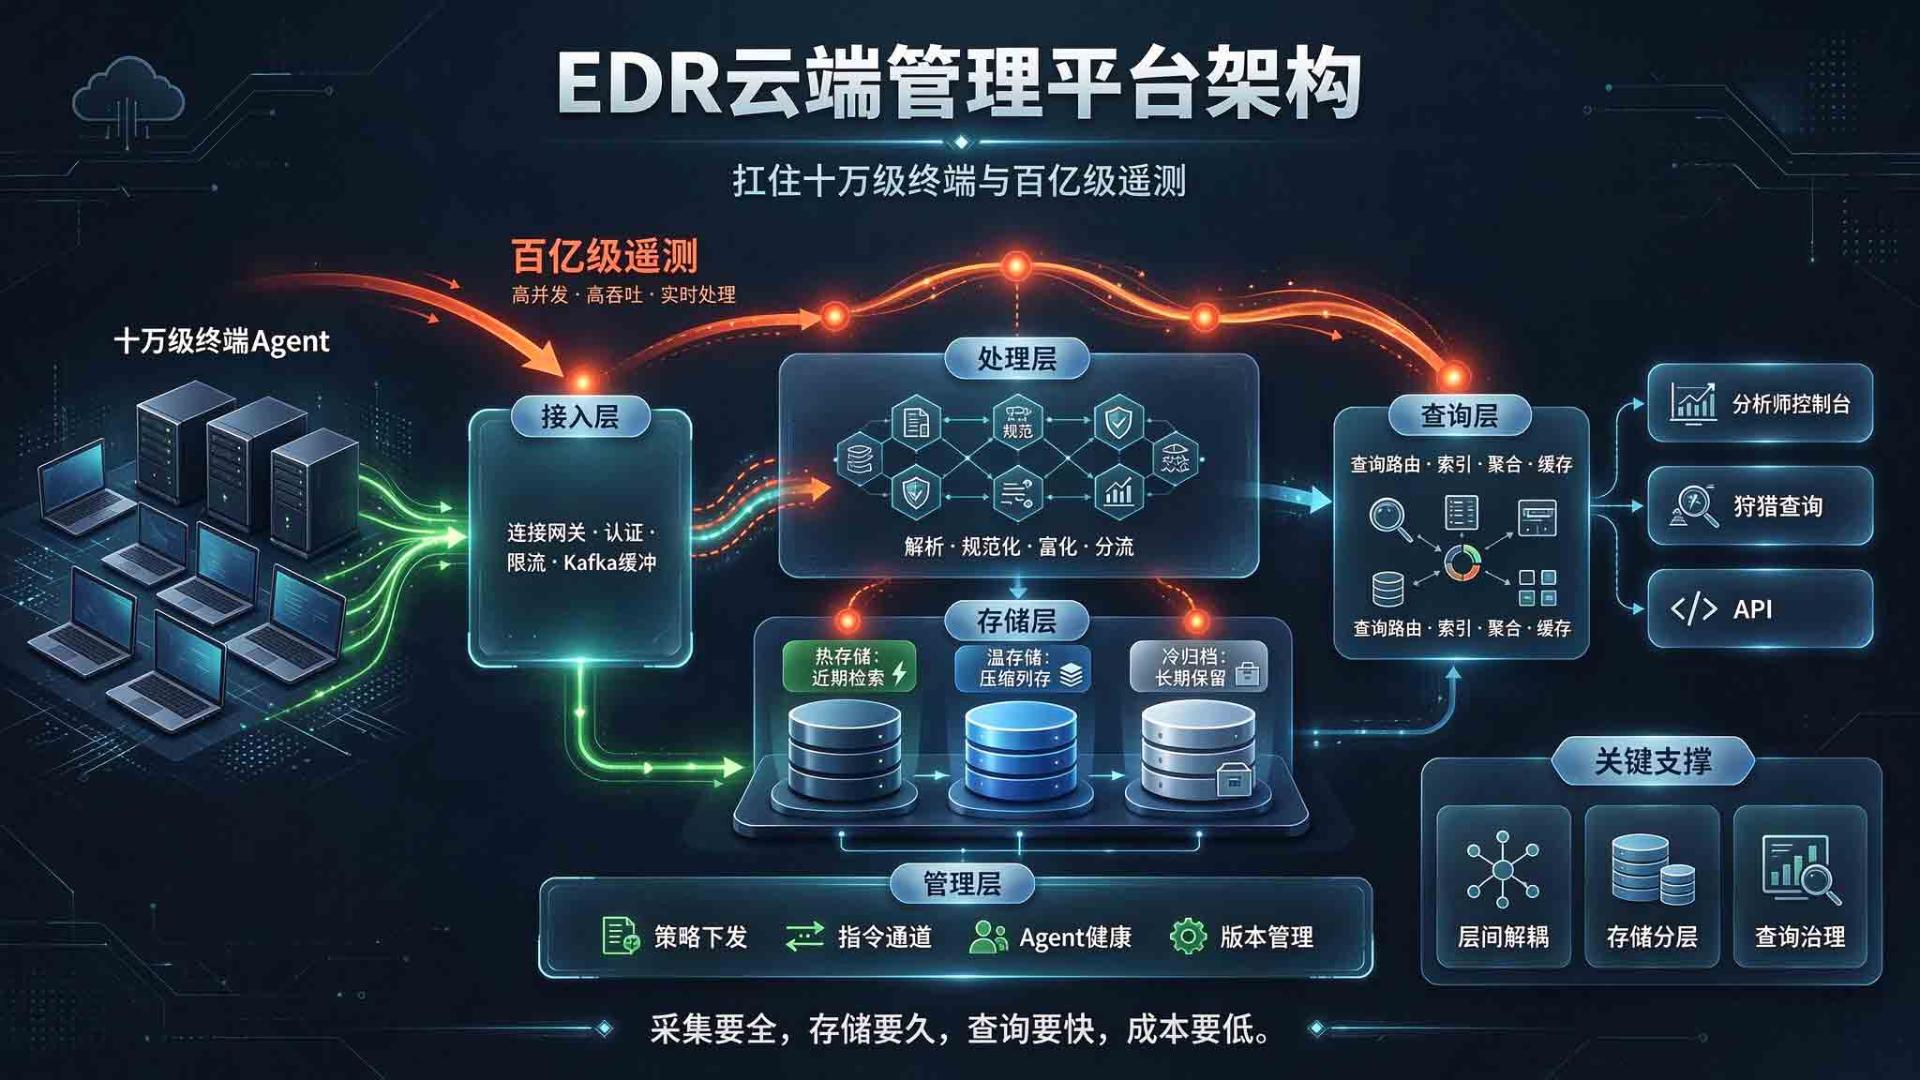
二、整体架构分层
┌──────────────────────────────────────────────────────┐
│ 应用层:控制台 · 告警视图 · 狩猎查询 · 报表 · API │
├──────────────────────────────────────────────────────┤
│ 查询层:查询路由 · 索引服务 · 聚合引擎 · 缓存 │
├──────────────────────────────────────────────────────┤
│ 存储层:热存储(可检索)· 温存储(压缩列存)· 冷归档 │
├──────────────────────────────────────────────────────┤
│ 处理层:解析 · 规范化(OCSF) · 富化 · 分流 · 去重 │
├──────────────────────────────────────────────────────┤
│ 接入层:连接网关 · 认证 · 限流 · 消息缓冲(Kafka) │
├──────────────────────────────────────────────────────┤
│ 管理层:策略下发 · 指令通道 · Agent 健康 · 版本管理 │
└──────────────────────────────────────────────────────┘
▲ ▲
│ 长连接(Agent 上行/下行) │ 管理 API
十万级终端 Agent 分析师 / 第三方系统
关键设计原则:接入、处理、存储、查询四层解耦。任何一层的容量瓶颈不应直接拖垮其他层——Agent 上报激增时,接入层用缓冲削峰;存储层扩容时不中断查询;查询高峰时不影响数据写入。
三、海量 Agent 连接管理
3.1 连接协议选型
Agent 与平台之间需要双向通信(上报 + 接收指令)。候选方案:
|
协议 |
优势 |
劣势 |
适用 |
|
HTTPS 短连接轮询 |
实现简单、穿透性好 |
延迟高、连接开销大 |
低频上报 |
|
WebSocket 长连接 |
双向、低延迟、穿透性好 |
需处理断线重连 |
常规方案 |
|
gRPC 流 |
高效、多路复用、强类型 |
代理兼容性需验证 |
高性能方案 |
|
MQTT |
轻量、专为海量设备设计 |
需额外 broker 集群 |
超大规模 |
实践中主流是 WebSocket 或 gRPC 长连接:常态保持一条连接用于指令下发,数据上报可在连接上复用或走独立的 HTTPS 批量接口。
3.2 连接网关的水平扩展
单机连接数有上限(受文件描述符、内存、CPU 影响)。十万级终端必须用连接网关集群:
- 分片路由:按租户ID 或终端 ID 哈希分片,同一终端的连接始终路由到同一网关节点(或通过 Redis 记录归属),避免状态漂移。
- 无状态化尽量彻底:网关本身不存业务状态,会话信息存Redis 等外部存储,网关宕机后终端重连到其他节点即可恢复。
- 负载均衡:四层负载均衡(如LVS)做流量入口,七层网关做协议处理。
3.3 惊群问题(Thundering Herd)
平台升级重启、网络抖动后,十万台终端可能在几十秒内同时重连,瞬间打满网关。缓解手段:
- 指数退避+ 随机抖动:Agent 重连间隔按 1s、2s、4s…指数增长,并叠加随机抖动(如 ±30%),把重连洪峰摊平到几分钟。
- 服务端限流与排队:网关对新建连接做速率限制,超限的连接请求排队或返回稍后重试。
- 分批放行:平台主动推送配置变更时分批执行,而非全量同时下发。
3.4 心跳与失联判定
- Agent 每30~60 秒心跳一次,心跳携带状态(版本、采集引擎状态、驱动是否加载、最近错误)。
- 平台侧连续N 次未见心跳判定为"离线",触发告警——离线可能意味着终端被关机,也可能意味着 EDR 被攻击者禁用,两者需要区分(通常结合最后心跳时间、是否有异常操作记录来判断)。
四、遥测数据管道
4.1 管道工序
Agent 上报(批量、压缩)
→ 接入网关(认证、限流)
→ 消息队列缓冲(Kafka / Pulsar)
→ 解析与规范化(统一 schema)
→ 富化(资产属性、威胁情报、地理位置)
→ 分流(按价值路由到不同存储)
→ 落库
4.2 消息队列的必要性
Kafka 这类消息队列在管道中是削峰 + 解耦的关键:
- 削峰:周一早上全员开机,上报量可能是平时的数倍,队列吸收尖峰,下游按稳定速率消费。
- 解耦:下游存储扩容、维护、故障时,数据在队列中堆积而不丢失(保留期内)。
- 回放能力:新增检测规则需要重算历史数据时,可以从队列回放近期数据(队列保留期通常1~7 天,更长的回放依赖存储层的重算能力)。
分区策略通常按"租户 ID"或"终端 ID"分区,保证同一终端的事件有序,同时便于并行消费。
4.3 规范化与分流
- 规范化:把不同OS(Windows/macOS/Linux)、不同采集源(内核回调/ETW/eBPF)的事件统一为同一 schema(如 OCSF)。这是后续跨终端查询和关联的前提。
- 分流:不是所有遥测都值得长期存储。按价值分级:
- 高价值事件(进程创建、文件落地、网络外联、告警)→全量入热存储;
- 低价值事件(高频注册表读取、常规文件读取)→采样或仅短期保留;
- 原始日志→ 全量入冷归档(成本低,供取证时回溯)。
五、存储分层:成本与性能的平衡术
这是平台架构中最考验设计的地方。业界常见三层模型:
|
层级 |
保留期 |
介质 |
查询特性 |
成本 |
|
热存储 |
7~30 天 |
搜索引擎 / 列式数据库(SSD) |
毫秒~秒级,支持复杂查询 |
高 |
|
温存储 |
90~180 天 |
压缩列存(Parquet/ORC)落地对象存储 |
秒~分钟级,批量扫描 |
中 |
|
冷归档 |
1 年以上 |
对象存储低频层 / 归档层 |
分钟~小时级,需先恢复 |
低 |
5.1 存储引擎选型
不同查询模式适合不同引擎:
- 点查与全文检索("某个文件哈希出现在哪些终端"):OpenSearch/Elasticsearch类倒排索引引擎,支持多字段组合检索。
- 大规模聚合与时序扫描("统计过去30 天各终端的告警数量分布"):ClickHouse 这类列式 MPP 数据库,向量化执行、压缩率高,聚合查询性能优于搜索引擎。
- 时序指标(Agent心跳、采集吞吐等平台自身指标):TDengine/InfluxDB 等时序数据库。
- 关系数据(资产、租户、策略、用户):关系型数据库(PostgreSQL/MySQL)。
成熟平台往往混合使用:搜索引擎负责告警与近期检索,列存数据库负责狩猎的大范围扫描,数据湖负责长期归档与回溯重算。
5.2 索引设计的关键取舍
索引不是越多越好。每增加一个索引字段,写入成本和存储成本都上升:
- 必须索引:时间戳、终端ID、租户 ID、进程路径/哈希、命令行(分词)、网络 IP/域名、规则 ID。这些是狩猎查询的高频过滤条件。
- 慎重建索引:超长文本(完整命令行可截断后索引)、高基数字段(如所有文件路径)。
- 写入优化:批量写入(如1000 条/批)、异步刷新索引(牺牲秒级实时性换取吞吐)、按时间分区(冷数据自动下沉)。
5.3 TTL 与生命周期管理
存储成本主要由保留期驱动。合理的做法是按数据用途设定不同 TTL:
- 告警与案件:长期保留(合规要求常为6 个月~1 年)。
- 高价值遥测:30~90天(覆盖多数应急响应窗口)。
- 低价值遥测:7~14天。
- 原始日志:按合规要求归档,可设1 年。
同时配置自动下沉策略:热存储中超期数据自动转温存储(压缩为列存),温存储超期后转冷归档,全程对查询层透明。
六、查询引擎:让狩猎查询不超时
6.1 查询类型与执行路径
|
查询类型 |
示例 |
执行路径 |
|
点查 |
查某哈希的命中记录 |
倒排索引,毫秒级 |
|
范围过滤 |
某终端某时段的进程列表 |
时间分区 + 终端索引 |
|
跨全网扫描 |
全网搜某命令行模式 |
列存批量扫描,可能分钟级 |
|
聚合统计 |
各规则告警趋势 |
预聚合 + 列存 |
|
关联深度查询 |
某进程的完整父子链 |
图/关系查询 + 多表 join |
6.2 查询治理
分析师随手发起的一个全网扫描查询,可能拖垮整个集群。治理手段:
- 查询分级:交互式查询(分析师等待)优先级高于批处理查询(后台任务),资源池隔离。
- 超时与中断:设置查询超时(如5 分钟),超时自动终止并提示缩小范围。
- 结果集上限:限制单次返回条数(如10 万条),超出时要求加过滤条件或改用导出任务。
- 查询预检:解析查询语句,估算扫描量,超过阈值时提示"该查询将扫描30 亿条记录,建议增加时间范围"。
- 缓存:对高频相同的查询结果做短期缓存(如5 分钟),避免重复扫描。
6.3 慢查询的可观测性
平台自身必须监控:查询 P50/P99 延迟、扫描数据量、缓存命中率、慢查询 top N。这些指标既用于运维,也用于指导索引优化。
七、多租户隔离
SaaS 模式下,平台同时服务多个客户(租户),隔离是硬要求。
7.1 数据隔离
- 逻辑隔离:所有数据带tenant_id,查询强制注入租户过滤条件(在查询层统一拦截,不允许绕过)。
- 物理隔离:对数据敏感度高的客户,提供独立数据库实例或独立集群(成本更高,但满足强隔离要求)。
- 存储分区:按租户分区可避免跨租户扫描,提升查询效率。
7.2 资源隔离:防"噪声邻居"
一个租户的大量上报或重量级查询,不应拖慢其他租户:
- Kafka 消费按租户配额限速;
- 查询资源池按租户配额分配(如每租户最多10 个并发查询);
- 存储IO 和 CPU 使用做配额与优先级控制。
7.3 合规要求
不同租户的数据可能有地域合规要求(数据不出境)。架构上需要支持按地域分集群部署(如国内集群、欧洲集群),租户数据固定落在指定地域。
八、检测执行位置:终端本地还是云端
平台架构必须决定检测逻辑在哪里运行,这直接影响带宽、延迟和终端资源:
|
位置 |
优势 |
劣势 |
适合的检测 |
|
终端本地 |
零延迟、离线可用、不上传原始数据 |
受终端资源限制,规则复杂度受限 |
已知恶意拦截、高频行为规则、勒索检测 |
|
云端 |
算力充足、可跨终端关联、规则更新即时 |
依赖网络、延迟高 |
跨终端关联、复杂 ML、威胁狩猎、情报回溯 |
实践中是分工:轻量规则在终端跑(毫秒级判定),复杂的跨终端分析和回溯在云端跑。规则下发采用"签名 + 版本 + 灰度"机制,Agent 定期拉取规则增量更新。
需要特别注意:云端检测不能是唯一防线。离线终端、隔离网环境的检测能力必须由终端本地规则保障。
九、指令下发通道
平台向 Agent 下发指令(隔离终端、扫描、取证收集、升级),这条链路的可靠性直接影响响应效果。
9.1 可靠性设计
- 指令持久化:指令先落库再推送,避免平台重启丢失。
- 在线推送+ 离线补偿:在线 Agent 走长连接即时推送;离线 Agent 上线后主动拉取待执行指令。
- 幂等设计:同一指令可重复下发,Agent侧按指令 ID 去重,避免重复执行(尤其是"隔离"这类动作)。
- 超时与重试:指令下发后等待回执,超时重试(限制次数),最终标记为"执行失败"并告警。
- 批量执行:全网任务(如全量扫描)需要分批下发、进度跟踪、可中途取消。
9.2 指令安全
指令通道是攻击者的高价值目标——伪造"解除隔离"指令可能让已被隔离的失陷终端重新联网:
- 指令必须签名,Agent验证签名后执行;
- 关键指令(解除隔离、卸载)需要二次授权;
- 通道全程TLS,并做双向认证。
十、平台自身的高可用与成本
10.1 高可用
- 无单点:接入网关、处理服务、查询服务全部多副本;存储层做副本或集群。
- 降级路径:存储层故障时,接入层继续接收数据落缓冲队列(保证不丢),查询层返回缓存或提示稍后重试。
- 跨可用区部署:关键组件跨AZ,避免单机房故障。
10.2 成本控制
云上 EDR 平台的最大成本项通常是存储和网络出口:
- 上报压缩:Agent上报前压缩(zstd/gzip),可减少 60%~80% 带宽。
- 增量上报:只上报变化,避免重复全量上传。
- 采样策略:低价值事件采样,直接减少数据量。
- 分层存储:冷归档用廉价对象存储,热数据控制在必要窗口内。
- 计算弹性:查询集群按负载弹性伸缩(夜间低峰缩容)。
十一、总结
EDR 云端管理平台的架构本质,是在四个互相制约的目标之间找平衡:
|
目标 |
关键手段 |
|
采集要全 |
分级采集、增量上报、终端侧过滤 |
|
存储要久 |
热/温/冷三层存储、按用途设 TTL、自动下沉 |
|
查询要快 |
混合存储引擎、分层索引、查询分级与治理 |
|
成本要低 |
压缩、采样、冷归档、弹性计算 |
再叠加三个工程约束:
- 规模弹性:接入层无状态化+ 连接网关分片,支撑十万级到百万级 Agent。
- 多租户安全:数据强制隔离+ 资源配额防噪声邻居 + 地域合规分集群。
- 可靠下发:指令持久化、幂等、签名校验,保证响应动作真实生效。
平台侧最容易被低估的是"查询体验"——检测能力再强,如果分析师发起一次狩猎要等十分钟才出结果,EDR 的实际价值就大打折扣。因此查询层的索引设计、分级治理和结果缓存,与技术选型同样重要。